当AI开始真正进入企业业务,GPU服务器就不再只是研发团队的一台高性能设备。
模型训练需要GPU,模型微调需要GPU,视觉识别需要GPU,大模型上线后的持续推理同样需要GPU。随着AI应用从测试阶段逐步进入生产环境,越来越多企业开始重新考虑一个问题:究竟是一次性购买GPU服务器,还是通过GPU服务器租赁的方式获得算力?
从目前行业的发展趋势来看,算力正在从单纯的硬件资源逐步转向更加灵活的服务资源。中国信通院《智能算力服务研究报告(2026年)》提出,用户对智能算力的需求正由传统资源采购向按需调用、弹性供给和任务式交付发展。
对于大量处于AI应用落地阶段的企业来说,GPU服务器租赁正在成为降低前期投入、提高算力使用灵活性的一种方式。
企业租GPU服务器,真正租的是“可用的AI算力”
很多企业第一次接触GPU服务器租赁时,只关注显卡型号。
但真正开始运行AI任务后才会发现,GPU只是整个计算节点的一部分。
模型训练需要显存,数据处理需要CPU和内存,模型文件和训练数据需要高速存储,多卡训练还需要高速互联,生产环境则需要稳定网络。也就是说,企业真正需要的不是简单的“几张GPU”,而是一套能够支撑业务运行的完整GPU服务器。
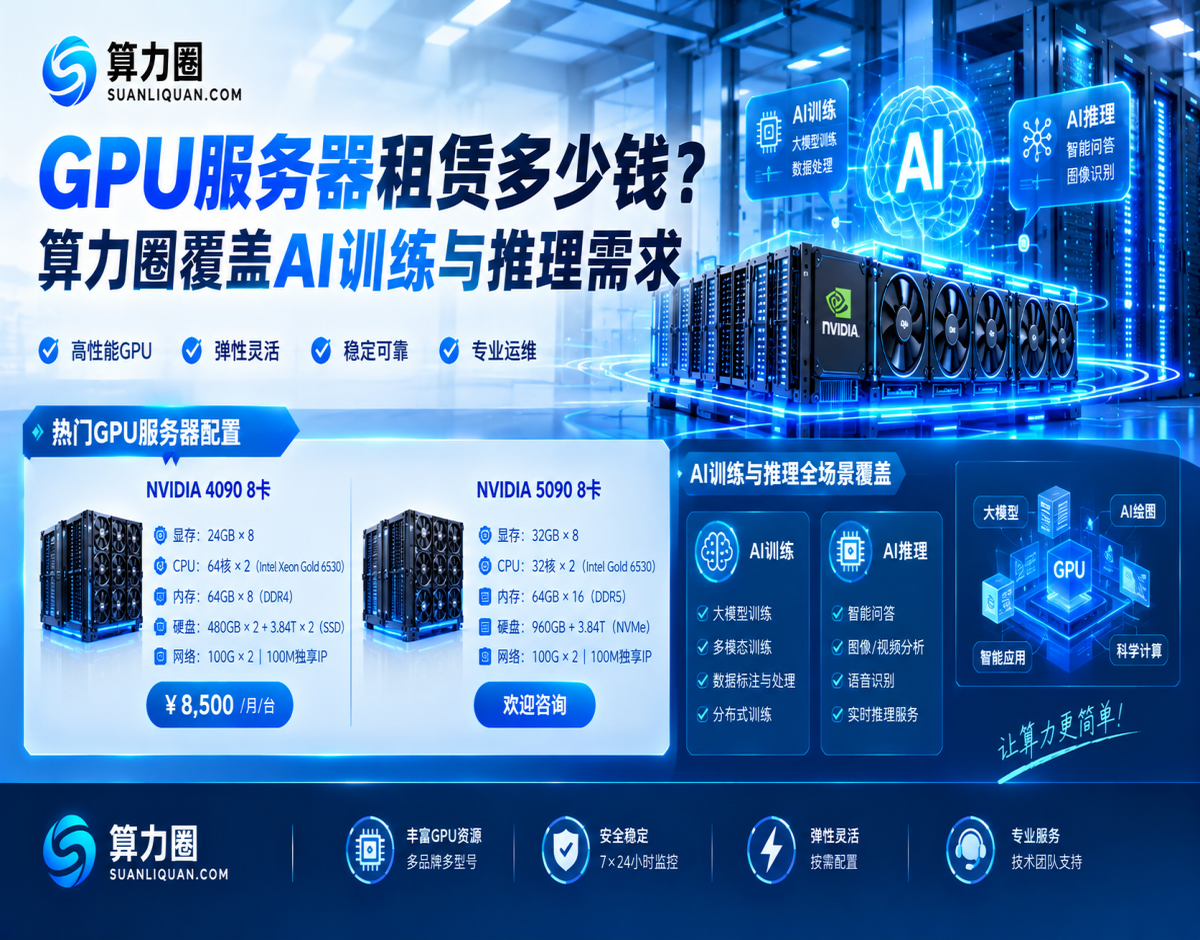
算力圈GPU页面目前同时提供GPU云服务器和GPU物理服务器,从入门级GPU到高端AI训练与推理平台形成了较完整的产品梯度。
这也让企业可以根据项目规模选择不同的算力形态。
AI项目刚起步,不一定需要一次买满整套硬件
AI项目与传统IT项目最大的不同之一,就是需求经常变化。
产品验证阶段可能只有少量任务;模型训练阶段算力需求短时间内快速增加;产品上线后又转向长期推理。企业如果按照未来最大规模一次性采购硬件,就需要提前承担较大的设备和基础设施投入。
GPU服务器租赁提供了一种不同的方式。
算力圈目前的GPU云服务器采用按需付费模式,可以根据GPU型号、任务需求创建实例,连接服务器后开展开发、训练和推理任务,业务完成后释放资源,从而减少不使用时产生的持续成本。官网将完整流程设计为“创建实例—连接服务器—运行任务—释放资源”。
对于AI创业团队、软件企业、科研机构以及传统企业的AI试点项目,这种模式可以把算力采购从一次性投入变成更贴近业务周期的持续支出。
GPU服务器租赁价格,不应该只看“每月多少钱”
当前GPU市场的一个明显特点,是不同型号之间的租赁价格差距非常大,而且随着供需、库存和AI应用需求变化,价格也会出现波动。
以算力圈官网目前公开的GPU云服务器预估价格为例,3090约1300元/月/卡,4090约1800元/月/卡,5090约2500元/月/卡;华为910B约12000元/月/卡;H20约27000元/月/卡;A800约33000元/月/卡;H100约68000元/月/卡;H200约80000元/月/卡。官网同时明确提示,GPU市场价格波动较大,实际交易价格以实时报价为准。
近期行业公开报道也指出,GPU、存储芯片以及云端推理服务价格存在上涨压力,算力成本正在成为AI企业经营中需要持续关注的一项支出。
因此,企业判断GPU服务器租赁行情时,不能只盯着一个“租金”。
真正需要关注的是:
GPU租金 + GPU利用率 + 任务完成效率 + 使用周期。
同样预算下,如果GPU长期闲置,再便宜的服务器也未必划算;如果项目每天持续高负载运行,那么配置匹配度就比单纯追求最低价格更加重要。
24GB、32GB、64GB、80GB、96GB、141GB,为什么显存越来越重要?
随着模型规模扩大,企业对GPU服务器的选择也越来越从“计算速度”转向“能否装下模型”。
算力圈当前GPU云服务器覆盖多个显存等级,例如3090和4090为24GB,5090为32GB,华为910B为64GB,A800和H100为80GB,H20为96GB,H200达到141GB。
显存越大,并不意味着所有任务都必须选择高端GPU,但对于大模型训练、模型微调、复杂推理以及多模态应用而言,显存往往直接影响模型部署方式。
因此,企业租赁GPU服务器时,第一步应该先确认模型大小、数据规模和推理方式,再选择显存和算力,而不是反过来。
大模型训练之外,GPU推理需求也在快速增加
过去提到GPU,很多人首先想到的是模型训练。
但今天AI真正进入企业之后,训练完成只是开始。
AI客服需要持续生成答案,智能体需要不断调用模型执行任务,视觉系统需要持续分析图片和视频,AI搜索和企业知识库需要处理大量实时请求。这些场景都会产生持续的GPU推理需求。
中国信通院2026年相关研究指出,大模型应用快速增长正在推动推理需求增加,智能算力服务也在向更加灵活的供给方式发展。
因此,GPU服务器租赁的客户群正在从单纯的“AI研发团队”,扩展到软件公司、企业AI项目、科研团队以及已经上线AI业务的生产企业。
短期测试、模型训练、长期推理,对服务器需求并不一样
一台GPU服务器适合什么业务,不能只看型号。
对于短期开发测试,可以优先考虑云GPU的快速开通与弹性使用;对于持续数周甚至数月的模型训练,需要重点关注显存、CPU、内存、存储和GPU互联;对于长期在线推理业务,则需要进一步考虑并发能力、网络稳定性和长期运行成本。
如果多卡协同是业务重点,服务器内部互联更需要重点评估。
算力圈当前物理GPU服务器覆盖8卡4090、5090、A100、A800、H100、H20、H200、H800以及B300,并配备不同规格的高速网络。例如A100、A800方案采用200G IB,H200和H800方案达到400G IB,B300-8卡则配置800G IB。
这类配置更适合需要多GPU并行运行的训练、计算和高性能AI任务。
国产算力,也可以纳入企业GPU服务器租赁规划
随着企业AI基础设施建设逐渐深入,算力选择正在变得更加多元。
算力圈当前除NVIDIA系列GPU外,还提供华为910B、910C和昆仑芯P800等国产算力服务器。官网对应方案均采用多卡配置,并配备较大容量内存、NVMe存储和高速网络。
对于需要进行国产算力环境适配、AI模型测试以及不同硬件平台验证的企业而言,多种算力资源可以提供更大的技术选择空间。
未来企业选择算力平台时,除了关注GPU性能本身,也会越来越重视模型适配、软件生态、部署方式以及后续服务能力。
算力圈,把GPU服务器租赁做成一套完整AI服务
企业真正开展AI项目后,通常不会永远停留在“租服务器”这一步。
模型训练之后可能需要部署推理服务,推理业务增长之后可能需要更多GPU;服务器数量增加之后又会产生高电机柜需求;如果企业还希望快速接入成熟的大模型,则需要API服务;当AI能力进入实际业务系统,又会需要完整的AI解决方案。
算力圈成立于2021年,总部位于河南郑州,长期深耕GPU算力租赁、高电机柜租用和大模型API服务。官网显示,公司拥有60余人专业研发团队、30+GPU机型、10万+企业客户,并形成大模型API、GPU算力租赁、高电机柜租用、AI解决方案四大产品线。
这意味着企业可以从一台GPU服务器开始,再根据实际业务逐步升级,而不需要每增加一种AI需求就重新寻找服务商。
从一台GPU服务器,到完整AI算力基础设施
一个比较典型的企业AI项目,可以从GPU云服务器开始。
先完成模型开发和技术验证;
再根据训练任务增加GPU资源;
项目上线后根据访问量配置推理算力;
业务规模扩大后使用GPU物理服务器;
需要长期部署时进一步配置高电机柜;
如果需要接入成熟模型,则通过统一大模型API调用;
最终再结合AI解决方案,把模型真正融入企业业务。
算力圈目前正是沿着这条链路构建产品体系:GPU负责底层算力,大模型API负责模型调用,高电机柜承担高密度算力基础设施,AI解决方案负责从模型选择、训练部署到上线运维的整体服务。
GPU服务器租赁,核心是让算力跟着业务走
2026年的AI市场正在从“模型能力展示”逐渐进入更加重视实际业务效果的阶段。
国家数据局披露,截至2026年7月底,全国智算总规模已经达到245万PFLOPS(FP16),算力资源正在加速向集约化、规模化和统一调度方向发展。
对于企业来说,这并不意味着一定要建设自己的大型GPU集群。
相反,在AI项目仍处于快速变化阶段时,根据业务需要租赁GPU服务器,可以让企业更加灵活地获得计算资源,把预算重点放在模型开发、产品应用和业务增长本身。
算力圈|算力租赁与大模型服务提供商
依托30+GPU机型、GPU云服务器、GPU物理服务器、高电机柜、大模型API和AI解决方案,为企业提供从AI开发、模型训练、推理部署到算力扩容的一体化服务。
无论是AI创业团队的GPU开发环境,还是企业级大模型训练与推理业务,算力圈都可以根据实际使用场景匹配相应算力资源。
让GPU算力不再成为企业AI项目的门槛,让每一份算力投入都更加贴近真实业务需求。