随着大模型、生成式AI、智能体、计算机视觉、数字人、AIGC以及科研计算不断发展,GPU已经成为AI应用的重要基础设施。
与此同时,企业获取GPU资源的方式也越来越丰富。除了常见的GPU云服务器,市场上还有GPU裸金属服务器以及GPU物理服务器等不同形态。
看起来都是“租GPU”,实际使用体验却存在明显差异。
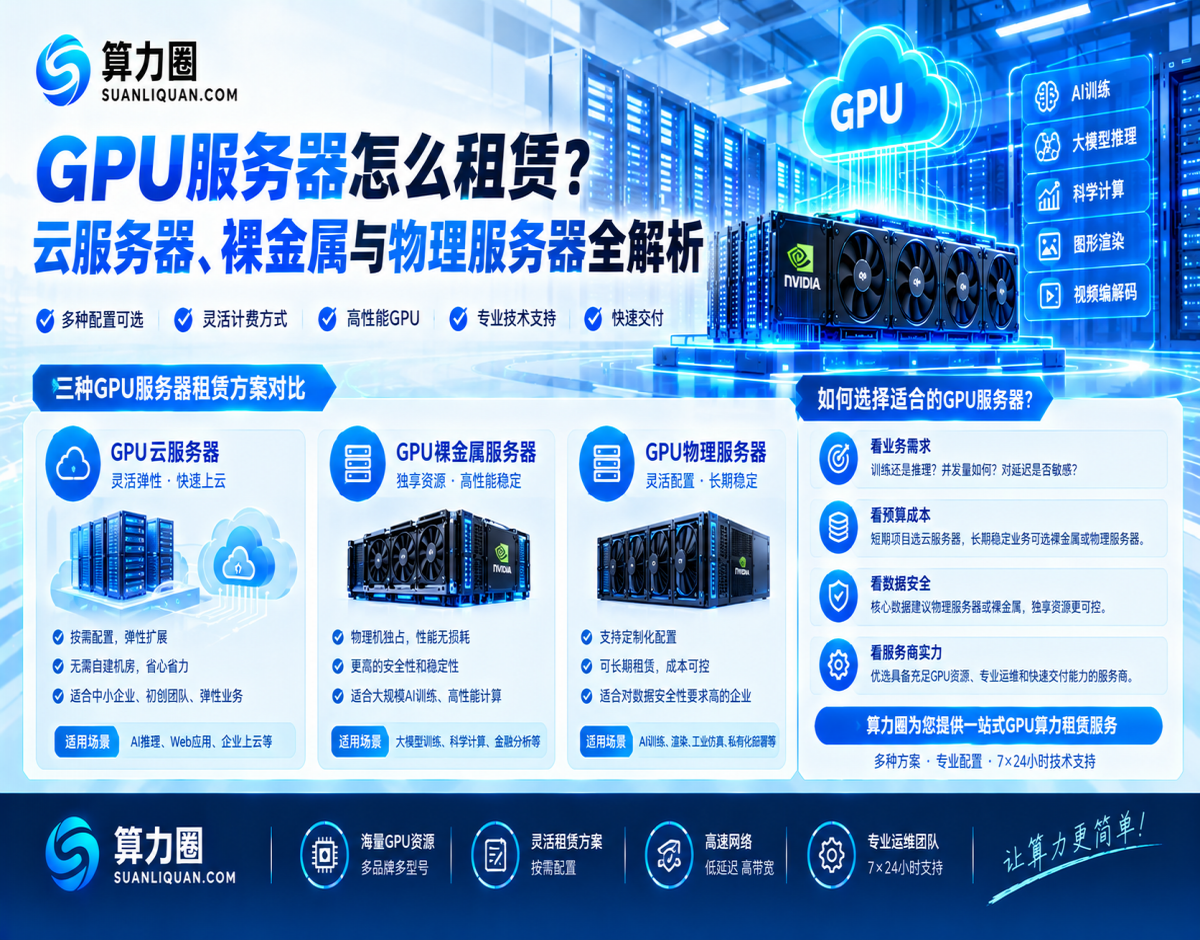
GPU云服务器更强调弹性和快速使用;GPU裸金属更强调独享硬件与云平台管理能力;GPU物理服务器则更适合长期、稳定、多卡以及专属算力部署。
因此,企业选择GPU服务器租赁时,真正需要考虑的不是“哪种名字更高级”,而是自己的AI业务究竟需要什么样的算力资源和使用方式。
三种GPU服务器,到底有什么区别?
简单理解,GPU云服务器是通过云平台交付的GPU计算资源,强调即开即用和弹性使用;GPU裸金属服务器则是在云服务模式下提供独享的物理服务器资源,同时保留自动化部署、云平台管理等能力;GPU物理服务器则通常是直接租赁一整台专属GPU服务器,拥有完整的硬件资源。
行业内对裸金属的定义通常强调“物理资源独享+云化管理”。例如阿里云将弹性裸金属服务器描述为融合物理机与云服务器优势的产品,既提供物理机级资源隔离,又具备分钟级交付、云盘、VPC和云平台管控等能力。
也就是说,裸金属和物理服务器在硬件层面可能高度接近,但在交付方式、云平台能力和运维管理方式上存在区别。
算力圈当前官网则明确提供GPU云服务器和GPU物理服务器两类产品,可以按照企业实际业务进行资源匹配。
GPU云服务器:适合快速开发、弹性测试和波动型业务
GPU云服务器最大的特点,是企业不需要提前采购整台硬件设备,就可以快速获得GPU计算资源。
算力圈官网目前提供3090、4090、5090、华为910B、H20、A800、H100、H200等GPU云服务器,并采用按需付费模式。官网目前展示的预估价格中,3090约1300元/月/卡、4090约1800元/月/卡、5090约2500元/月/卡,910B约12000元/月/卡,H20约27000元/月/卡,A800约33000元/月/卡,H100约68000元/月/卡,H200约80000元/月/卡。
官网同时提供“创建实例—连接服务器—运行任务—释放资源”的使用流程,任务完成后释放资源即可停止计费。
因此,GPU云服务器比较适合以下业务:
AI算法开发与测试、模型微调、短期训练任务、AIGC内容生成、视觉AI验证、科研项目以及业务量存在明显峰谷变化的AI应用。
对于还处在产品验证阶段的企业,GPU云服务器可以降低前期硬件投入,让企业先验证AI项目,再决定后续算力规模。
GPU裸金属服务器:适合追求独享资源与云化管理的企业
GPU裸金属可以理解为“专属物理服务器+云平台能力”。
与普通虚拟化GPU云服务器相比,裸金属服务器强调客户独享底层物理资源,同时通过云平台完成实例交付、网络配置、镜像管理和生命周期管理等操作。行业资料显示,裸金属服务器的特点就在于兼顾物理机性能和云服务的弹性、自动化能力。
对于需要较高硬件资源隔离,同时又希望拥有云平台操作体验的AI企业来说,GPU裸金属具有较强的适配性。
尤其是以下场景,可以重点考虑这类模式:
大型模型训练、对硬件资源独占要求较高的业务、多GPU计算、需要快速重装和调度的研发环境,以及已经拥有成熟云计算运维体系的企业。
需要注意的是,GPU裸金属并不是简单意义上的“更贵的GPU云服务器”,它更大的特点是底层物理资源和云管理能力的组合。
GPU物理服务器:适合长期运行与多卡AI任务
GPU物理服务器则更接近传统意义上的“整机专属算力”。
企业租赁一台GPU物理服务器后,可以获得整台机器的GPU、CPU、内存、存储和网络资源,特别适合长期运行、稳定训练和多卡协同任务。
算力圈当前GPU物理服务器覆盖4090-8卡、5090-8卡、A100-8卡、A800-8卡、H100-8卡、H20-8卡、H200-8卡、H800-8卡、B300-8卡,同时提供华为910B、910C和昆仑芯P800等国产算力方案。
例如,目前官网展示的4090-8卡物理服务器预估价格约7800元/月/台,5090-8卡约13500元/月/台,A100-8卡约36000元/月/台,A800-8卡约34000元/月/台,H100-8卡约90000元/月/台,H200-8卡约135000元/月/台;B300-8卡目前页面展示约380000元/月/台。官网明确提示市场波动较大,实际交易价格以报价为准。
这一类资源更适合长期模型训练、高性能推理、多卡深度学习、科学计算以及对服务器资源有较高独享需求的企业。
三种模式怎么选?可以按照业务阶段判断
如果企业只是做AI模型测试,或者GPU需求存在较大不确定性,GPU云服务器的弹性优势更加明显。
如果企业已经进入生产环境,需要独享硬件,同时又希望通过云平台快速完成服务器交付和管理,那么GPU裸金属是值得关注的一种资源形态。
如果企业需要长期使用完整GPU服务器,并且任务以多卡训练、批量推理或高性能计算为主,那么GPU物理服务器更加贴近这种使用方式。
可以简单理解为:
临时用、弹性用——优先看GPU云服务器;
独享硬件、云化管理——关注GPU裸金属;
长期用、多卡用、专属用——重点考虑GPU物理服务器。
最终仍然需要结合模型、显存、GPU数量、网络、存储和租赁周期进行判断。
GPU服务器租赁,2026年的价格行情怎么看?
GPU算力市场的价格并不是固定不变的。
不同GPU型号、显存容量、服务器配置、租赁周期、区域资源以及市场供需都会影响最终价格。
从近期国内市场采样来看,9月17日Mysteel公布的部分GPU租赁参考数据中,京津冀地区A100 80G单卡包月价格约8.39元/卡/小时,A800 80G单卡按需约7.82元/卡/小时,H20 96G单卡按需约8.95元/卡/小时,H100 80G整机包月约11.55元/卡/小时,RTX 4090 24G单卡按需约2.07元/卡/小时。该数据属于区域市场参考价格,并不代表全国统一成交价。
另一份9月14日京津冀市场数据也显示,不同租赁方式之间存在价格差异,例如RTX 4090按需约2.16元/卡/小时、包月约1.79元/卡/小时,A800按需约7.50元/卡/小时、包月约6.47元/卡/小时。该市场数据同样说明,租赁方式、区域和供需变化都会影响实际报价。
因此,企业查看GPU服务器租赁价格时,不能拿单一市场价格直接套用,而应该同时询问:
GPU型号是什么?是单卡还是整机?按需还是包月?服务器配置如何?网络和存储是否包含?租赁周期多长?
只有把这些条件放在一起,价格比较才有实际意义。
GPU服务器租赁,不是显卡越贵越合适
企业做AI项目时,最容易产生的误区就是“预算允许就选择最高端GPU”。
事实上,不同业务对算力的要求完全不同。
AI入门开发和轻量级推理,可能更关注GPU利用率和整体成本;模型微调需要关注显存和计算持续性;大型模型训练则可能更关注多GPU协同;AI推理业务需要综合考虑显存、并发量和响应速度。
算力圈当前GPU云资源从24GB显存的3090、4090,到32GB的5090,再到64GB的910B、80GB的A800/H100、96GB的H20以及141GB的H200,形成了较完整的显存梯度。
因此,选GPU应该先看模型需要多少显存、任务需要多少计算量,再确定GPU型号。
多卡训练,更应该关注服务器整体配置
当模型进入多卡训练阶段,GPU之间需要进行大量数据通信。
此时除了GPU本身,还需要关注CPU、内存、NVMe存储和GPU互联。
算力圈当前多卡物理服务器覆盖多个GPU平台,例如A100-8卡、A800-8卡采用200G IB互联,H200-8卡采用400G IB互联,B300-8卡进一步采用800G IB网络。
因此,对于大模型训练和高性能计算任务,企业不能只问“有没有8卡”,还应该进一步确认:
8张什么GPU、显存多少、CPU多大、内存多少、存储多快、GPU之间采用什么互联。
这些参数最终都会影响多卡任务的运行效率。
国产算力,也可以纳入GPU服务器租赁方案
企业AI基础设施的选择正在更加多元化。
算力圈当前除NVIDIA系列GPU外,还提供华为910B、910C以及昆仑芯P800等国产算力服务器。官网展示的910B-8卡方案为64GB显存、200G以太网,910C-8卡为128GB显存、200G以太网,昆仑芯P800-8卡则配置96GB显存和400G以太网。
对于需要进行国产算力适配、不同AI芯片环境测试或行业模型部署的企业而言,多元化资源能够增加算力配置的选择空间。
因此,未来企业选择GPU服务器时,除了关注性能和价格,还需要考虑模型生态、应用兼容以及后续技术支持。
算力圈,覆盖从云GPU到专属AI算力
企业选择算力服务商,实际上并不仅仅是在购买GPU。
当AI项目从测试走向生产之后,还可能产生模型训练、多卡部署、高功率机柜、大模型API以及行业AI解决方案等新的需求。
算力圈成立于2021年,总部位于河南郑州,长期深耕GPU算力租赁、高电机柜租用、大模型API服务,并形成大模型API、GPU算力租赁、高电机柜租用、AI解决方案四大产品线。官网披露拥有60余人专业研发团队、30+GPU机型,并以99.9%服务可用性为服务指标。
在GPU算力方面,算力圈同时提供GPU云服务器和GPU物理服务器;在基础设施方面提供高电机柜;在模型层面提供统一大模型API;在应用层面则提供从模型选型、训练部署到上线运维的AI解决方案。
这使企业可以根据AI项目生命周期逐步调整资源:
项目初期,用GPU云服务器快速验证;
开发成熟后,根据需求选择GPU物理服务器;
多卡规模扩大后,再配置高电机柜;
需要快速接入大模型时,通过SuanLiQuan API连接主流模型;
进入行业应用阶段,则进一步通过AI解决方案完成业务落地。
选择GPU服务器,关键是匹配“算力使用方式”
未来GPU服务器租赁市场的竞争,不只是GPU数量的竞争。
随着AI训练、推理、智能体和行业应用持续发展,企业越来越关注资源利用率、交付效率、稳定性以及整体服务能力。中国信通院2026年智能算力服务研究也指出,智能算力服务正在向资源池化、弹性供给、异构算力协同和更加精细化的服务方向发展。
因此,GPU服务器租赁可以根据企业业务分成不同路径:
开发测试,看弹性;
生产部署,看稳定;
大型训练,看多卡;
私有部署,看独享与基础设施;
长期运营,看综合成本与服务能力。
没有一种GPU服务器适合所有企业,适合自身业务周期和模型需求的配置,才更容易实现算力资源的有效利用。
算力圈,让GPU算力选择更贴近企业真实需求
从GPU云服务器,到GPU物理服务器,再到高电机柜、大模型API和AI解决方案,算力圈正在构建一套覆盖“算力获取—模型服务—基础设施—AI应用”的产品体系。
企业无需在项目初期就一次性确定未来全部算力需求,可以根据实际业务发展逐步扩容。
无论是AI算法团队进行模型训练,还是企业部署视觉识别、智能客服、AIGC、AI智能体、科研计算等业务,都可以根据任务周期、GPU显存、计算规模以及并发需求匹配相应资源。
算力圈|算力租赁与大模型服务提供商
依托30+GPU机型、GPU云服务器、GPU物理服务器、高电机柜以及统一大模型API,为企业提供覆盖AI开发、模型训练、推理部署和应用落地的算力服务。
GPU服务器怎么租,不只看GPU型号,更要看业务场景、使用周期和整体算力需求。