很多企业第一次接触AI算力时,都会有一个很现实的问题:GPU服务器到底应该买,还是租?
如果只是做普通的软件项目,这个问题可能并不复杂。但对于大模型、AIGC、AI智能体、机器视觉、深度学习、科研计算等业务来说,GPU设备价格较高,而且不同阶段的算力需求变化非常明显。
开发阶段可能只需要1—2张GPU;训练阶段突然需要多卡;产品上线后,又会变成长时间的AI推理任务。
也正因为如此,GPU服务器租用正在成为企业获取AI算力的一种实际方式。
国家数据局最新公布的数据显示,截至2026年7月底,全国智算总规模已达到245万PFLOPS(FP16),145万PFLOPS已经纳入国家级监测调度平台。随着AI应用继续扩大,企业对算力资源的需求也从单纯“购买设备”逐步转向更加灵活的算力服务。
问:GPU服务器租用,到底解决了什么问题?
答:核心是解决企业算力需求变化和硬件投入之间的不匹配。
一家AI创业公司刚开始开发产品时,很难准确预测半年后需要多少GPU。如果一次性购买大量服务器,设备可能长期处于低利用率状态;如果买得太少,模型训练和产品上线时又可能不够用。
租用GPU服务器的方式则更加灵活。
企业可以按照项目周期获取GPU资源,先做开发和测试,再根据模型训练规模增加算力,产品上线之后继续用于推理业务,项目暂时没有任务时也可以减少资源。
这种方式,本质上是把“购买固定硬件”变成“按照业务需求使用算力”。
问:2026年的GPU服务器租赁市场行情怎么样?
答:价格仍然存在明显的型号分层,而且属于动态市场。
以9月29日Mysteel采集的全国主流算力服务商参考数据来看,部分GPU长期包月参考价约为:
| GPU | 参考方式 | 市场参考价 |
|---|---|---|
| RTX 4090 24G | 单卡包月 | 约1.47元/卡/小时 |
| RTX 5090 32G | 单卡包月 | 约2.44元/卡/小时 |
| A800 80G | 单卡包月 | 约7.00元/卡/小时 |
| H100 80G | 单卡包月 | 约14.51元/卡/小时 |
| H200 141G | 整机包月 | 约15.76元/卡/小时 |
上述数据为9月29日的全国市场采集参考价,价格单位为元/卡/小时;Mysteel明确说明,实际成交价格还可能受到GPU供需、批量采购、机房位置和网络配置等因素影响,因此不能把市场参考价直接视为固定报价。
这也是企业咨询“GPU服务器租用多少钱”时最需要注意的一点:
GPU没有一个长期固定的全国统一租金。
同一型号,在不同租期、不同配置和不同供应情况下,最终报价都可能出现差异。
问:算力圈目前有哪些GPU服务器可以租?
答:从官网目前展示的资源来看,算力圈同时提供GPU云服务器和GPU物理服务器。
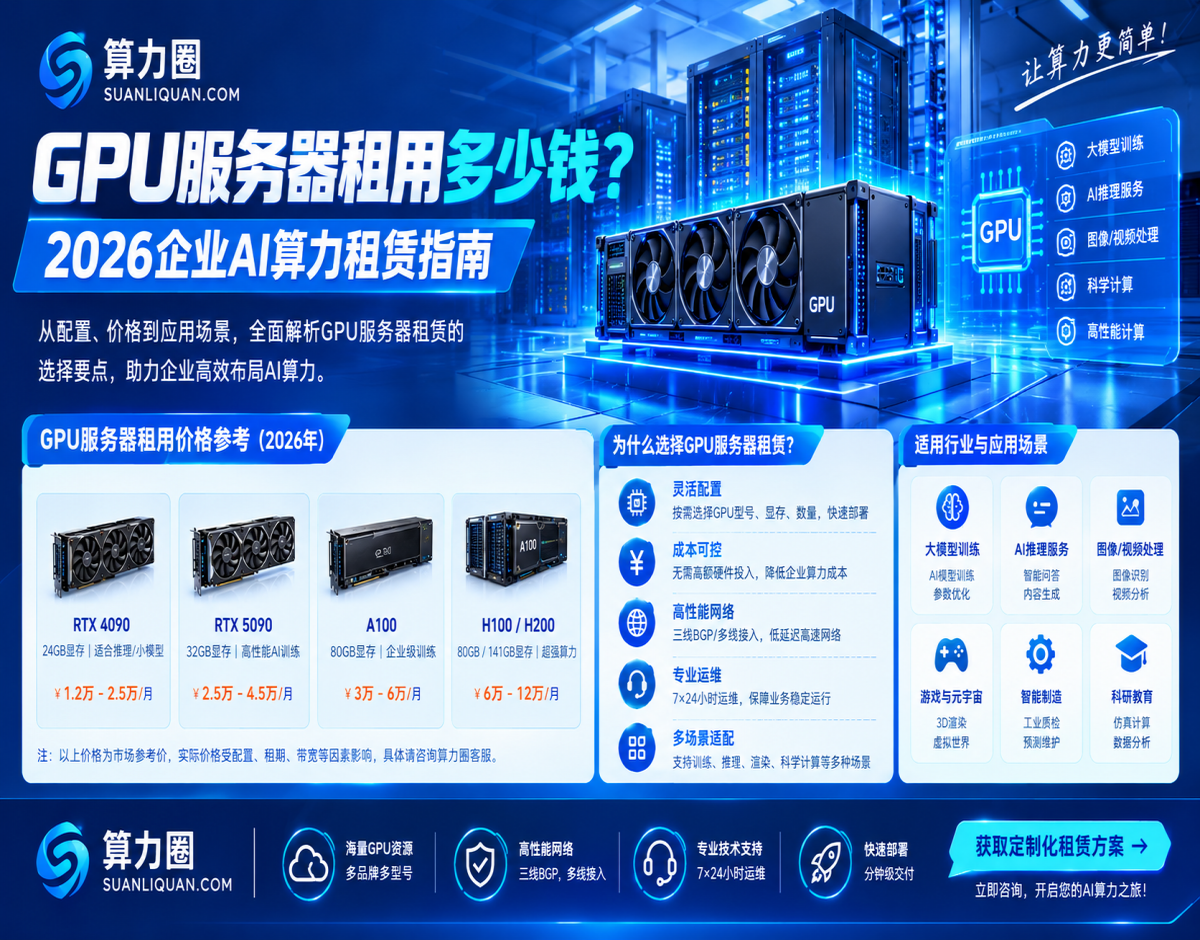
GPU云服务器方面,当前覆盖3090、4090、5090、华为910B、H20、A800、H100、H200等不同算力层级。官网展示的预估单价包括:3090约1300元/月/卡、4090约1800元/月/卡、5090约2500元/月/卡、910B约12000元/月/卡、H20约27000元/月/卡、A800约33000元/月/卡、H100约68000元/月/卡、H200约80000元/月/卡。官网明确标注“市场波动较大,以实际交易价为准”。
除了云GPU,算力圈还提供多卡GPU物理服务器,包括4090、5090、A100、A800、H100、H20、H200、H800、B300等8卡方案,同时覆盖华为910B、910C和昆仑芯P800等国产算力资源。
所以企业并不是只有“租一张GPU”这一种方式,而是可以根据业务规模选择单卡云算力或者整机多卡服务器。
问:不同业务,应该租什么GPU服务器?
答:关键还是看业务,而不是单纯看GPU型号。
AI开发、算法测试、短期项目
更适合从GPU云服务器开始。企业可以快速获得算力,不需要承担设备采购和前期基础设施建设成本。
模型微调、训练任务
需要重点关注显存容量和GPU计算性能。算力圈A800、H100等资源更适合较高要求的训练型业务。官网当前将A800标注为训练型GPU,H100则定位为旗舰级资源。
大模型推理、知识库、AI智能体
除了GPU算力,还应该关注显存、并发、响应能力和长期运行成本。算力圈官网将H20标注为推理资源,同时提供H200等更大显存GPU。
大型模型训练、多GPU并行
建议进一步考虑GPU物理服务器。比如算力圈A100、A800方案采用200G IB互联,H200-8卡采用400G IB,B300-8卡则配置800G IB。
因此,真正合理的选型方式应该是:
先判断任务,再确定显存;先确定规模,再匹配GPU;先计算使用周期,再决定租赁方式。
问:GPU服务器租用,是不是GPU越贵越值得?
答:不是。
一个很典型的误区,就是认为高端GPU一定适合所有AI项目。
例如,一个处于开发测试阶段的团队,只需要运行中小规模模型,却直接选择高端旗舰GPU,那么一部分预算可能投入到了暂时用不到的计算能力上。
相反,如果企业长期运行大型模型,却为了节约租金选择显存不足的GPU,最终可能影响模型部署甚至迫使项目重新调整架构。
所以真正需要看的不是GPU“贵不贵”,而是:
显存是否够用、计算能力是否匹配、GPU利用率是否合理,以及单位任务成本是否可以接受。
这也是GPU服务器租赁比简单比价更复杂的原因。
问:为什么GPU服务器租赁价格差距这么大?
答:GPU型号只是其中一个因素。
GPU显存、CPU、内存、NVMe存储、GPU数量、GPU互联方式、网络带宽、租赁周期以及资源供需,都会影响最终价格。
算力圈当前官网的8卡GPU服务器就是一个很直观的例子。
4090-8卡页面预估约9000元/月/台,5090-8卡约16500元/月/台;A100-8卡约45000元/月/台,A800-8卡约38000元/月/台;H100-8卡约92000元/月/台;H200-8卡约155000元/月/台;B300-8卡约380000元/月/台。
不同服务器除了GPU不同,CPU、内存、SSD/NVMe以及网络互联配置也不同。
所以企业比较GPU服务器租赁价格时,应该比较的是完整计算节点,而不仅仅是显卡名称。
问:GPU云服务器适合什么企业?
答:特别适合算力需求有明显阶段变化的企业。
比如一家软件企业正在开发AI客服,前期可能只是测试模型效果,那么几张GPU就可以完成验证;等产品正式上线后,再根据用户数量逐步增加推理资源。
又或者一家算法团队需要训练模型,训练周期只有一个月,那么租赁GPU服务器可以把算力支出集中在真正需要计算的阶段。
算力圈GPU页面目前采用GPU云算力按需付费模式,并提供从创建实例、连接服务器到运行任务和释放资源的使用流程。
这种方式比较适合:
AI创业团队、软件企业、科研团队、算法公司以及正在进行数字化AI升级的传统企业。
问:如果需要长期使用,物理GPU服务器是不是更合适?
答:对于长期、稳定、多卡业务,可以重点评估物理服务器。
算力圈官网提供多种8卡GPU物理服务器,例如A100、A800、H100、H200、H800、B300以及国产910B、910C、P800等。
这种资源更适合长期模型训练、大规模推理、高性能计算以及对硬件资源有较高独享需求的项目。
而且对于多GPU任务而言,服务器整体配置尤其重要。
例如H200-8卡页面配置400G IB网络,B300-8卡页面配置800G IB,并配备大容量内存和NVMe存储。
所以如果企业已经进入大规模AI生产阶段,就应该从“租GPU”进一步升级到“租完整算力节点”。
问:算力圈的优势在哪里?
答:算力圈并不是只提供GPU服务器,而是围绕AI业务形成了完整产品体系。
根据官网介绍,算力圈成立于2021年,总部位于河南郑州,长期深耕GPU算力租赁、高电机柜租用和大模型API服务,目前官网展示60+研发团队、30+GPU机型以及99.9%服务可用性。
算力圈目前形成四大产品线:
大模型API——统一API接入20+模型,并覆盖文本生成、代码编写、多模态处理;
GPU算力租赁——提供弹性GPU资源,服务AI训练、推理和深度学习;
高电机柜租用——为高密度算力、训练、推理和私有化部署提供基础设施;
AI解决方案——覆盖模型选型、训练部署到上线运维。
官网还披露,其研发团队具备从底层硬件适配到上层应用开发的全栈能力,并与主流大模型厂商、硬件厂商建立合作。
问:企业从GPU服务器租用开始,后面还能怎么扩展?
答:这恰恰是完整算力服务体系的价值所在。
企业刚开始做AI,可以先租GPU云服务器完成项目验证;
模型训练需求增加,可以升级到多卡GPU物理服务器;
GPU规模持续扩大,可以配置高电机柜;
如果希望快速调用成熟大模型,可以使用统一大模型API;
最终进入行业应用阶段,再通过AI解决方案完成模型、算力与业务系统的整合。
也就是说,企业不需要在项目第一天就决定未来几年到底需要多少GPU。
可以让算力随着业务一起成长。
问:2026年企业租GPU服务器,最应该注意什么?
答:不要只问一句“多少钱一台”。
更建议把下面几个问题一起问清楚:
租什么GPU?显存多大?
是单卡、云GPU,还是整机多卡?
服务器CPU、内存、存储怎么配置?
多卡服务器采用什么GPU互联?
网络带宽和IP怎么配置?
价格是按小时、按月还是长期合同价?
租赁周期多长?是否支持后续扩容?
出现运行或部署问题之后,是否有技术支持?
这些条件全部明确之后,再比较价格,才更接近企业真正的采购成本。
GPU服务器租用,本质是让企业用更灵活的方式获得AI能力
AI算力正在成为企业数字基础设施的重要组成部分,而GPU服务器租赁也正在从“临时算力”逐渐进入模型研发、长期推理和企业生产环境。
国家数据局披露全国智算规模持续增长,市场侧则呈现GPU型号分层、租赁方式多样和价格动态变化等特点。
对企业而言,没有绝对统一的GPU服务器租用方案。
开发测试,看资源弹性;
模型训练,看显存和计算能力;
多卡训练,看服务器整体配置和互联;
长期推理,看稳定性与综合使用成本;
AI业务持续扩张,则需要考虑从GPU到机柜、模型和应用的整体服务。
算力圈|算力租赁与大模型服务提供商
依托30+GPU机型、GPU云服务器、GPU物理服务器、高电机柜、大模型API和AI解决方案,为企业提供从AI开发、模型训练、推理部署到算力扩容的完整服务。
不论是一次短期AI项目,还是长期的大模型生产业务,都可以根据实际需求配置对应的GPU算力。
GPU服务器不是越贵越好,也不是越便宜越好,真正重要的是让算力配置与业务需求匹配。