从近两年的GPU租赁市场来看,企业对算力的需求正在变得更加细分。一边是大模型训练、智能体开发和高并发推理推动计算需求持续增长,另一边是GPU硬件、机架级系统和高速互联技术不断升级。对企业而言,如何在性能、成本和部署效率之间找到平衡,已经成为算力采购绕不开的问题。
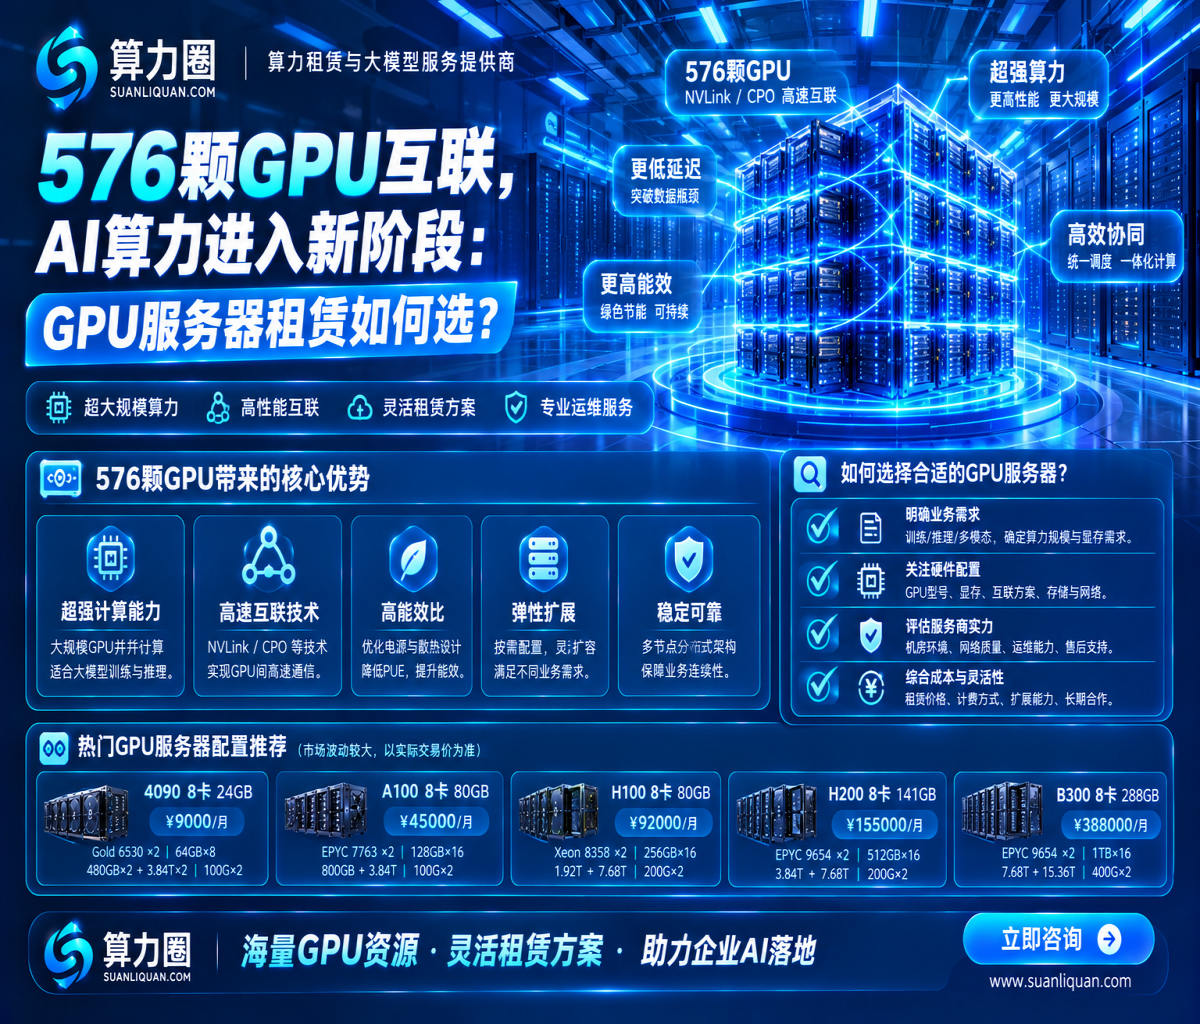
英伟达正在推进的Rubin Ultra NVL576,为这一趋势提供了一个观察窗口。按照公开技术路线,该系统计划将576颗Rubin Ultra GPU整合进跨机架的NVLink计算域,并通过更高带宽的互联技术提升大规模计算的协同能力,预计于2027年下半年推出。具体规格和交付时间仍以英伟达后续公布的信息为准。
从这类机架级系统的发展可以看出,GPU算力的竞争早已不只是单张显卡的性能比拼。随着集群规模扩大,GPU互联、网络带宽、供电能力和散热条件,都会影响最终的计算效率。
不过,前沿硬件不断升级,并不意味着每家企业都需要直接部署超大规模集群。对于正在开发AI应用、训练专用模型或搭建推理服务的团队来说,先根据实际任务选择合适的GPU服务器,往往更有利于控制投入、缩短部署周期,并为后续扩容留出空间。
与其一开始追求最大的算力规模,不如先找到适合当前业务的配置。 算力圈提供GPU云服务器与多卡GPU物理服务器租赁,覆盖从开发测试到模型训练、推理部署等不同场景,帮助企业按需选择算力资源,让预算真正用在业务需要的地方。
一、从NVL576看GPU发展:算力规模越大,系统协同越重要
过去,企业选择GPU服务器,往往先看显卡型号和显存容量。随着模型规模、推理并发量和训练任务复杂度不断提升,仅看单张GPU已经不够。
在多卡训练中,GPU之间需要频繁交换数据;在大模型推理中,显存容量、内存带宽和通信效率会影响模型运行方式;当多个机架组成集群后,网络拓扑、供电能力与散热条件也会成为影响整体效率的关键因素。
NVL576的技术方向说明,下一代AI基础设施正在向更大规模的协同计算发展。英伟达公布的Rubin路线还包括NVL72等机架级系统,面向不同规模的训练与推理任务。
但大规模集群并不是所有项目的起点。
如果企业正在验证一个模型、开发AI产品,或为现有业务增加智能问答和内容生成能力,先租用适合当前任务的GPU资源,通常更容易控制初期投入。等到业务量、模型规模和并发需求真正增长,再升级到多卡服务器或更大规模的集群,也不迟。
二、GPU服务器租赁,不必一开始就投入整套硬件
自建GPU服务器,除了采购硬件,还要考虑机房、电力、制冷、网络、设备维护及后续升级。对于需求尚未稳定的团队,这些投入可能占用大量预算,也会增加项目启动的复杂度。
GPU服务器租赁则可以根据任务需求选择资源。算力圈提供GPU云服务器与GPU物理服务器,覆盖AI开发测试、模型推理、深度学习和多卡计算等场景。
如果任务量不固定,可以先从云GPU开始。
例如,开发人员需要测试模型、运行实验或短期处理数据时,可以按需选择GPU资源;任务完成后,根据平台规则释放不再使用的实例,减少闲置资源带来的成本。
如果需要持续运行或多卡协同,可以考虑物理GPU服务器。
对于模型训练、持续推理、较大规模的数据处理等任务,多卡物理服务器能够提供相对固定的硬件环境。此时需要同时关注显卡型号、显存容量、CPU、内存、存储和互联网络,确保整套配置能够支撑实际工作负载。
租赁的价值,不是让企业无条件追求更高端的硬件,而是把资源投入与项目进度联系起来。
三、算力圈GPU服务器租赁,覆盖多种算力需求
算力圈官网提供多档GPU云服务器和多卡物理服务器方案,企业可以根据模型规模、显存需求、训练周期和预算进行选择。
GPU云服务器:适合开发、测试与灵活扩容
官网当前展示的部分GPU云服务器参考价格如下:
| GPU型号 | 单卡显存 | 官网预估价格 |
|---|---|---|
| NVIDIA RTX 3090 | 24GB | 约1300元/月/卡 |
| NVIDIA RTX 4090 | 24GB | 约1800元/月/卡 |
| NVIDIA RTX 5090 | 32GB | 约2500元/月/卡 |
| 华为昇腾910B | 64GB | 约12000元/月/卡 |
| NVIDIA H20 | 96GB | 约27000元/月/卡 |
| NVIDIA A800 | 80GB | 约33000元/月/卡 |
| NVIDIA H100 | 80GB | 约68000元/月/卡 |
| NVIDIA H200 | 141GB | 约80000元/月/卡 |
以上为官网页面展示的预估价格,实际价格可能随资源供需、租赁周期、配置和服务条件变化。
不同GPU并非简单地按价格高低排序。比如,开发测试与图像生成可能更关注成本和兼容性;大模型推理需要综合考虑显存、吞吐量和并发要求;模型训练则可能更看重多卡通信、长时间运行稳定性和数据读取效率。
选型时,建议先明确模型及框架、显存需求、预计并发量和任务时长,再确定具体配置。
多卡物理服务器:面向持续计算与集群任务
如果项目需要多张GPU同时工作,算力圈官网也展示了多卡物理服务器方案,包括:
| 物理服务器配置 | 官网预估价格 |
|---|---|
| 8卡RTX 4090 24GB | 约9000元/月/台 |
| 8卡RTX 5090 32GB | 约16500元/月/台 |
| 8卡A100 80GB | 约45000元/月/台 |
| 8卡A800 80GB | 约38000元/月/台 |
| 8卡H100 80GB | 约92000元/月/台 |
| 8卡H200 141GB | 约155000元/月/台 |
以上价格同样为官网预估价,具体以实际报价为准。不同型号的CPU、内存、存储和高速网络配置存在差异,不能只凭GPU数量判断性能或性价比。
对于多卡训练或高并发推理,建议提前确认GPU之间的通信方式、网络配置、软件环境和数据存储需求。尤其在分布式训练场景中,显卡数量增加并不必然带来同比例的性能提升,实际效率还与模型、并行策略和通信开销有关。
四、Rubin Ultra还在前方,企业现在应该怎么规划算力?
新一代GPU平台值得关注,但企业不必为了等待下一代硬件而推迟现有项目,也不必仅因为新品路线图发布,就提前投入超出当前需求的资源。
更实际的做法,是把算力规划分成三个阶段。
第一阶段:先验证业务。
用合适的云GPU完成模型运行、应用开发和性能测试,弄清楚任务真正需要多少显存、计算资源和存储空间。
第二阶段:根据负载调整配置。
当模型、数据规模或并发需求上升后,再评估更高显存GPU、多卡物理服务器及高速互联方案,避免长期使用不匹配的配置。
第三阶段:为长期扩展预留空间。
如果业务已经进入持续训练或规模化推理阶段,就需要把服务器、网络、供电、散热和机房条件放在一起评估。对于高密度GPU集群,机柜功率与散热能力同样重要,不能等到设备到位后才考虑基础设施是否承载得住。
这也是为什么GPU租赁和高电机柜规划需要结合项目进度进行。先把当前业务跑通,再根据真实需求扩容,比单纯追逐硬件代际更有实际意义。
五、为什么了解算力圈?从GPU资源到AI服务,按项目选择
算力圈成立于2021年,总部位于河南郑州,业务覆盖GPU算力租赁、高电机柜租用、大模型API服务和AI解决方案。官网介绍,其服务面向AI训练、推理、深度学习及企业AI应用等场景,并提供不同类型的算力资源。
对于企业用户,算力采购不应只停留在“租哪张卡”这一步。真正落地时,还要考虑模型能否运行、环境是否兼容、数据存储是否够用,以及未来增加算力时能否平稳调整。
算力圈提供的产品组合,可以让企业按项目阶段选择:
GPU云服务器: 用于开发验证、短期任务和弹性算力需求。
多卡GPU物理服务器: 用于持续计算、模型训练和多卡任务。
高电机柜租用: 为需要自行部署服务器的企业评估机柜功率、网络和基础设施条件。
大模型API与AI解决方案: 适用于希望先接入模型能力,或进一步推进企业AI应用的团队。
不同项目需要的服务并不相同。对于初创团队,先通过云GPU或模型API验证需求,可能比建设完整的GPU集群更合适;对于已有成熟业务的企业,则可以根据长期负载规划物理服务器与机房资源。
结语:不必一步到位,但要为增长留出空间
从单张GPU到多卡服务器,再到Rubin Ultra NVL576所代表的超大规模互联架构,AI基础设施正在不断升级。未来的竞争不仅是显卡算力的竞争,也是网络、内存、供电、散热和系统协同能力的竞争。
但对正在推进AI项目的企业来说,算力规划仍然应该从业务本身出发:需要多大模型、预计多少并发、训练还是推理、任务会持续多久,以及预算能够支持什么样的配置。
算力圈提供从云GPU到多卡物理服务器的多种租赁选择,帮助企业根据当前需求部署算力,并在业务发展后进一步调整资源规模。
不必等到下一代算力平台到来,才能开始做AI。先选对当下的GPU资源,把项目跑起来,再让算力跟着业务成长。