过去,GPU服务器更多出现在科研机构、专业技术团队和大型互联网企业的机房里。如今,情况正在发生变化。
从大模型训练、AI视频生成,到智能制造、智慧医疗、金融风控和教育数字化,越来越多业务开始把GPU算力作为日常运行的一部分。企业不再只是讨论要不要用AI,而是开始考虑模型怎么训练、应用如何部署、推理任务如何持续运行,以及不断增长的计算需求该由谁来承接。
算力需求的变化,也让GPU服务器租赁从相对专业的技术服务,逐渐走进更多企业的采购视野。
市场数据能够反映这种变化。根据Mysteel发布的2026年10月算力租赁月报,RTX 5090在长三角市场的单卡按需租赁价格环比上涨13.3%,成为当月涨幅较明显的型号之一;而11月6日发布的周报显示,国内GPU租赁市场整体价格稳中分化,H100价格上涨较为突出,部分A100和消费级GPU价格则有所回落。
这说明,算力市场的热度仍在,但不同GPU型号的供需情况并不相同。企业面对的已经不只是“有没有GPU可用”,还包括资源是否匹配、部署是否及时、服务能否跟上,以及长期使用成本是否可控。
算力正在成为企业开展AI业务的重要生产资源。与其一次性投入大量资金购买设备,不如根据项目阶段选择合适的GPU服务器,让计算资源跟着业务需求走。
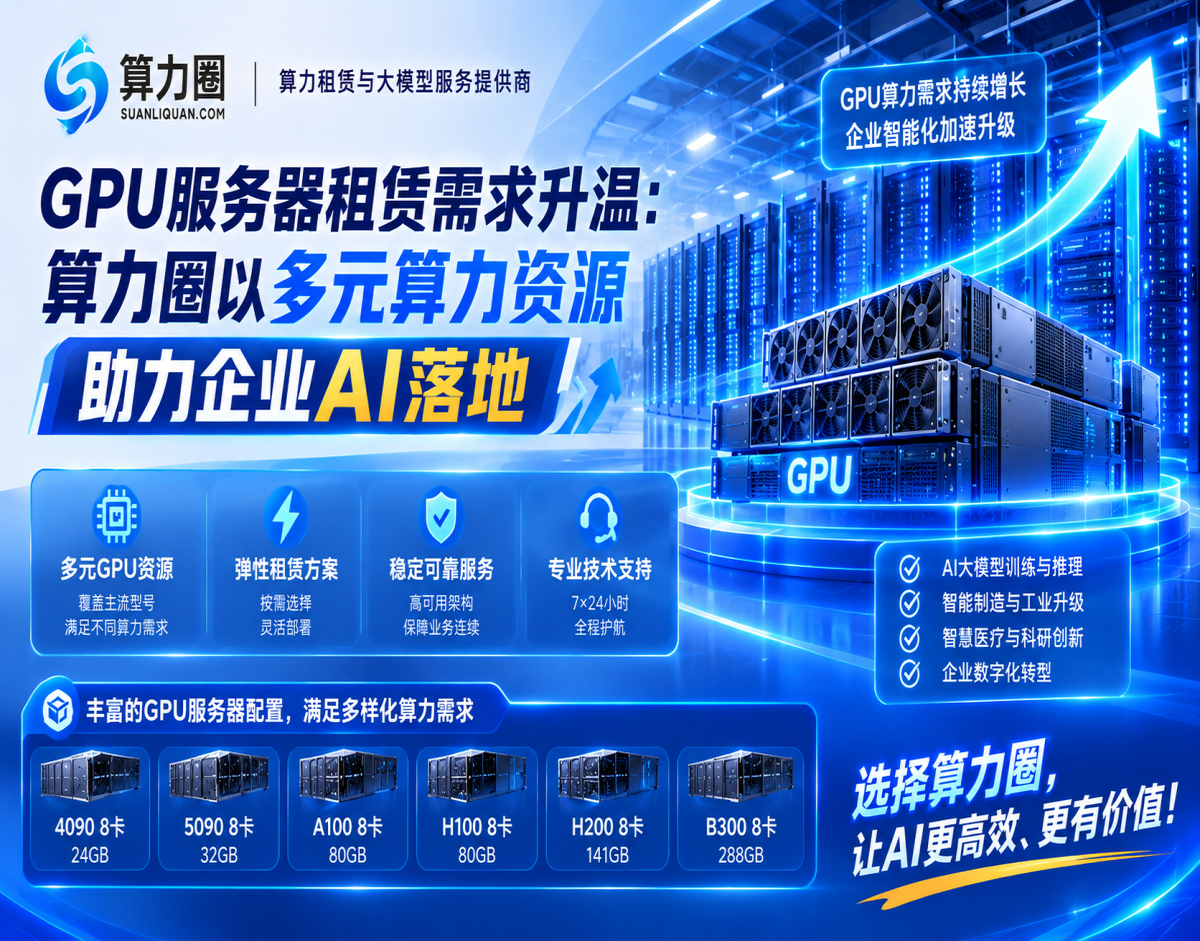
作为算力租赁与大模型服务提供商,算力圈依托多年市场销售、技术服务与运营管理经验,围绕GPU算力租赁、高电机柜租用、大模型API和AI解决方案形成多元产品布局,为企业提供从算力资源到AI应用的配套服务。
一、AI应用走向业务现场,GPU算力需求正在变得更加具体
AI行业的变化,不只是模型越来越大,而是应用场景越来越多。
过去,企业使用AI可能只是做一些简单的文本生成或智能问答;现在,AI开始进入产品研发、生产管理、客户服务、医学辅助、金融分析和教学科研等实际工作流程。应用一旦进入持续运行阶段,对计算资源的要求也会随之提高。
智能制造领域,机器视觉、工业质检、设备状态识别和生产数据分析,需要GPU承担模型训练与推理任务。企业既要考虑算法效果,也要关注计算资源能否持续供应。
智慧医疗领域,医学影像分析、辅助诊断研究和医疗数据处理等应用,对模型计算能力和数据处理环境有一定要求。项目在研发、测试及部署阶段,可能需要不同规格的GPU资源。
智慧金融领域,智能风控、知识检索、数据分析和金融智能助手等业务,既涉及模型推理,也涉及大量数据处理。计算资源的性能、稳定性和部署环境需要结合具体业务评估。
智慧教育领域,AI教学助手、智能问答、教学内容生成和科研计算等应用不断丰富,学校及教育科技企业可以根据教学规模和项目周期灵活安排算力。
这些场景看似不同,却有一个共同点:AI应用不能只停留在模型演示阶段,必须有足够适配的计算资源,才能真正进入业务流程。
对于许多企业来说,自行采购GPU服务器意味着较高的前期资金投入,还要考虑硬件更新、设备维护、机房环境和后续扩容。通过GPU服务器租赁获得计算资源,则可以把部分固定资产投入转化为按需使用的服务成本,让项目启动更灵活。
二、GPU服务器租赁怎么选?不要只盯着显卡型号
GPU型号是选型的重要依据,但并不是唯一依据。
同样是GPU服务器,单卡云算力和多卡物理服务器的使用方式并不相同;即使显卡型号相同,CPU、内存、存储、网络和机房环境不同,也可能影响实际任务效率。
企业在租赁前,建议先明确三个问题。
业务需要什么样的计算能力?
如果是算法开发、模型测试和轻量推理,可以优先考虑单卡或少量GPU资源;如果涉及大模型微调、批量推理和多任务并行,就需要进一步评估显存容量、GPU数量以及多卡协同能力。
资源需要使用多长时间?
短期实验、阶段性项目和持续运行的生产业务,对资源租赁方式有不同要求。短期需求更看重部署灵活性,长期需求则需要关注资源保障、服务响应和整体租赁成本。
服务器之外的条件是否匹配?
GPU性能只是计算效率的一部分。服务器内存、存储读写、网络带宽、GPU互联、供电和散热条件,都可能成为影响任务运行的因素。特别是多卡服务器,不能只看显卡数量,还要确认整机配置是否适合实际工作负载。
选型的目标不是追求最高配置,而是让每一份算力都能发挥作用。配置过低,任务可能跑不动;配置过高,又容易增加不必要的成本。
三、算力圈GPU算力租赁:云服务器与物理服务器灵活选择
围绕不同企业的算力需求,算力圈提供GPU云服务器和GPU物理服务器两类产品,覆盖从开发测试到模型训练、推理部署等不同应用阶段。
1. GPU云服务器:按需使用,降低项目启动门槛
GPU云服务器适合需要快速部署、灵活调整资源和控制前期投入的企业。
算力圈GPU云服务器页面展示了NVIDIA RTX 3090、RTX 4090、RTX 5090,以及华为910B、NVIDIA H20、A800、H100、H200等型号,能够满足不同显存规模和计算需求。
部分官网参考配置及价格如下:
| GPU型号 | 显存 | 官网预估价格 |
|---|---|---|
| NVIDIA RTX 3090 | 24GB | 1300元/月/卡 |
| NVIDIA RTX 4090 | 24GB | 1800元/月/卡 |
| NVIDIA RTX 5090 | 32GB | 2500元/月/卡 |
| 华为910B | 64GB | 12000元/月/卡 |
| NVIDIA H20 | 96GB | 27000元/月/卡 |
| NVIDIA A800 | 80GB | 33000元/月/卡 |
| NVIDIA H100 | 80GB | 68000元/月/卡 |
| NVIDIA H200 | 141GB | 80000元/月/卡 |
例如,官网展示的RTX 5090云服务器配置为32GB显存、16核CPU、96GB内存和500GB NVMe数据盘,参考价格为2500元/月/卡。
对于正在开展模型测试、算法开发和AI应用验证的团队,可以根据任务规模选择GPU资源。项目完成后,也可以根据实际使用规则释放不再需要的资源,减少设备闲置带来的成本压力。
2. GPU物理服务器:多卡部署,满足持续计算需求
当业务需要多张GPU协同工作,或者需要相对独立的服务器环境时,可以考虑GPU物理服务器。
算力圈官网展示的物理服务器产品覆盖RTX 4090、RTX 5090、A100、A800、H100、H200、H20、H800,以及华为910B、910C和昆仑芯P800等型号。
其中,部分八卡GPU服务器参考价格如下:
| 服务器型号 | GPU配置 | 官网预估月租 |
|---|---|---|
| NVIDIA 4090-8卡 | 8×24GB | 9000元/月/台 |
| NVIDIA 5090-8卡 | 8×32GB | 16500元/月/台 |
| NVIDIA A100-8卡 | 8×80GB | 45000元/月/台 |
| NVIDIA A800-8卡 | 8×80GB | 38000元/月/台 |
| NVIDIA H100-8卡 | 8×80GB | 96000元/月/台 |
| NVIDIA H200-8卡 | 8×141GB | 155000元/月/台 |
以官网展示的RTX 5090八卡服务器为例,整机配置包括双路Intel Gold 6530处理器、1024GB DDR5内存、960GB系统盘、双3.84TB NVMe数据盘,以及双100G以太网卡,并提供100M独享带宽和1个公网IP,参考价格为16500元/月/台。
对于多卡模型开发、AI推理服务、图像视频生成和持续计算任务,物理服务器可以提供相对独立的硬件资源。具体能否满足模型运行需求,还需要结合显存占用、软件框架、GPU互联和任务并行方式进行评估。
从单卡云算力到八卡物理服务器,企业可以根据项目进展选择资源,不必在业务尚未成熟时就承担过重的硬件投入。
四、算力圈的优势,不只是提供GPU设备
GPU服务器租赁看起来是硬件资源服务,实际交付却涉及资源匹配、技术支持、部署管理、网络环境和后续运营等多个环节。
算力圈长期深耕算力租赁与大模型服务领域,依托市场销售、技术服务和运营管理经验,累计服务企业客户超过万家,业务覆盖智能制造、智慧医疗、智慧金融、智慧教育等多个领域。
在长期服务企业的过程中,算力圈逐步形成了以GPU算力为基础、以AI应用为延伸的产品体系。
GPU算力租赁: 提供多型号GPU云服务器和物理服务器资源,企业可以根据模型规模、计算任务和预算选择适合的配置。
高电机柜租用: 面向多卡GPU服务器、计算集群及高功耗设备部署需求,提供相应机柜资源选择,结合供电、散热和网络条件规划设备上架方案。
大模型API服务: 通过SuanLiQuan API统一接入DeepSeek、GLM、MiniMax、Kimi、豆包、通义千问等主流模型,支持文本生成、代码编写及多模态应用等场景,帮助企业降低多模型接入与管理的复杂度。
AI解决方案: 结合企业实际业务需求,围绕模型选型、算力配置、部署实施和应用落地提供配套服务,让AI技术不只停留在工具体验,而是逐步融入业务流程。
这些服务并不是彼此孤立的产品。企业可以先通过GPU云服务器开展算法验证,再根据业务规模租用物理GPU服务器;当设备数量增加时,可以进一步规划高电机柜资源;如果希望快速使用主流模型,也可以通过大模型API接入相应能力。
从算力资源到模型服务,再到AI应用建设,企业可以根据自身发展阶段逐步配置,不必一开始就建设完整的技术体系。
五、算力市场越热,越要重视服务与资源匹配
GPU算力市场的热度,给企业带来了更多资源选择,也让租赁服务商之间的差异更加明显。
同一型号的GPU,报价可能受到地区、配置、租期、网络环境和交付条件影响。对于企业来说,单纯比较月租价格,并不能完整反映实际使用成本。
选择GPU服务器租赁服务商时,可以重点了解以下几方面:
资源是否丰富: 是否有不同显存、不同性能定位的GPU型号,能否根据业务变化调整配置。
配置是否透明: CPU、内存、存储、网络、带宽和IP等信息是否清楚,是否存在容易忽略的额外费用。
技术支持是否到位: 是否能够协助处理环境部署、系统配置和常见运行问题。
资源是否便于扩展: 当项目从测试进入生产阶段,能否根据计算需求增加GPU数量或调整服务器类型。
服务是否覆盖完整流程: 除了提供设备,是否具备机柜、网络、模型API及AI应用方面的配套能力。
算力需求增长并不意味着所有GPU型号都会持续涨价。正如近期市场数据所显示,不同型号的价格走势存在分化。企业更应该结合自身项目周期和实际负载做决策,而不是单纯追逐市场热点。
算力圈依托多年积累的市场销售、技术服务、运营管理经验及产品网络资源,持续围绕企业实际需求优化算力服务。对于需要GPU服务器租赁、算力扩容或AI应用部署的企业,可以结合设备清单、预计使用周期和业务场景,进一步匹配适合的资源方案。
六、让算力跟上业务,让AI真正创造价值
AI应用的竞争,最终还是要回到业务本身。
对制造企业而言,算力要服务于生产效率和质量管理;对医疗机构而言,计算资源要支撑科研与智能化应用;对金融和教育领域而言,模型能力需要与实际业务流程结合,才能体现价值。
算力圈始终坚持以技术创新为驱动、以客户需求为导向,围绕GPU算力租赁、高电机柜租用和大模型API服务持续完善产品与服务,并结合自身市场经验和技术服务能力,为企业提供更灵活的算力资源选择与AI解决方案。
无论是刚刚启动AI项目,需要几张GPU完成模型测试;还是业务进入规模化阶段,需要多卡物理服务器和高电机柜支撑持续运行,都可以根据实际需求制定部署计划。
算力不是越多越好,适合业务、用得起来、能够持续支撑发展,才是真正有价值的算力。
如果你正在寻找GPU服务器租赁服务,或准备为企业AI项目规划计算资源,可以访问算力圈官网,了解不同GPU型号、服务器配置及相关服务。